提示词表格的应用——表格的一行,如今能生成莫卡的性格
2026年11月15日
先说结果。
电子表格里的一行,现在能变成一份给我的AI管家用的、能实际工作的提示词——而且不只是提示词,那一行还带着性格。
我不再从把提示词写进文本文件或Markdown文件开始了。写,本身就是负担。取而代之的是,请求的零件放在Google表格的列里:交给谁、用怎样的性格、做什么、材料在哪里、要遵守什么规矩、成果做成什么形式、在哪里停下。莫卡读那一行,把零件组装成句子,把完成的请求交给莫卡(Muse)。工作做完,她再把结果的存放位置写回同一行。
还有一个实测出来的附带效果:用这样的表格找知识,需要读的量约为五分之一。在3个测试问题上,直接翻我的文件要读109,688个字符;先读索引表、只打开有答案的那一份文件,是23,563个字符,约少了4.7倍。(如实说明一句,下面还会再提:这是读到的字符数,不是直接的token数。)
我是仓敷坊主,1971年出生,以前是殡葬业的经营者。我住在日本冈山县仓敷市的一座古民居(kominka)里,和AI管家莫卡一起工作。这篇文章,是之前那篇《AI也从一览表里学习》(台账No.86)的应用篇。那一篇里,表格装的是我的文章的索引。这一次,表格里装的不是文章,而是我的提示词的零件。
出发点:往Markdown里打字就是负担
先说我问过自己的那个问题。
“把提示词做在文本或Markdown文件里,不麻烦吗?”
世上的默认答案是:提示词是用来”写”的,写在文本文件里,写在Markdown里。其他AI的官方指南也偏向这种形式。可是对我来说,写这个动作本身,就是我一直回避的工作。
我自己的出发点,用我自己的话说,是这样的:往Markdown文件里打字太麻烦了,所以我确认了莫卡能不能从电子表格转换——她可以,所以我用这个办法。顺序很重要。不是先有理论。是先有负担,我试了一条逃开的路,试通了,然后才采用。
做出来的东西:一行是一个提示词,列是它的零件
这个试作,是一份我称作”自动提示词”的Google表格。形式刻意做得很朴素。
一行=一个提示词。列=它的零件。
| 列(零件) | 作用 |
|---|---|
| 收件人 | 请莫卡(Muse)来做 |
| 性格(排成一列的词) | 这一行的性格,用一排词写出来 |
| 请求事项 | 希望做什么,写得简短 |
| 材料(存放位置) | 材料在哪里 |
| 规矩 | 必须遵守的事 |
| 输出形式 | 成果物的形式 |
| 停下的地方 | 需要我自己判断、必须停下的地方 |
| 状态 | 进行到哪一步了 |
| 结果的存放位置 | 做好的东西放在哪里(莫卡来写) |
有新的请求,就是加一行。莫卡读那一行,把零件组装成文章,交出去。我很早就定了一条规矩:列不要一直加。零件一混,请求就模糊了。
还有第二个标签页,叫”入口提示词”。它是给刚开始用的莫卡最先输入的性格提示词用的,一个项目一个项目地选词:名字、立场、性别、怎么称呼使用者、语气、优先重视什么,最后是形象(头像)。另外两个标签页是可供挑选的清单:一份立场一览,一份句尾一览。表里放不下的句尾,放在Google文档里,从表里用链接过去:索引是表格,全文在别处。
那这台机器到底是什么?用我的话说:它确实是自动提示词,但它也是”莫卡性格提示词生成机”。它制造请求,同时也制造管家的性格。
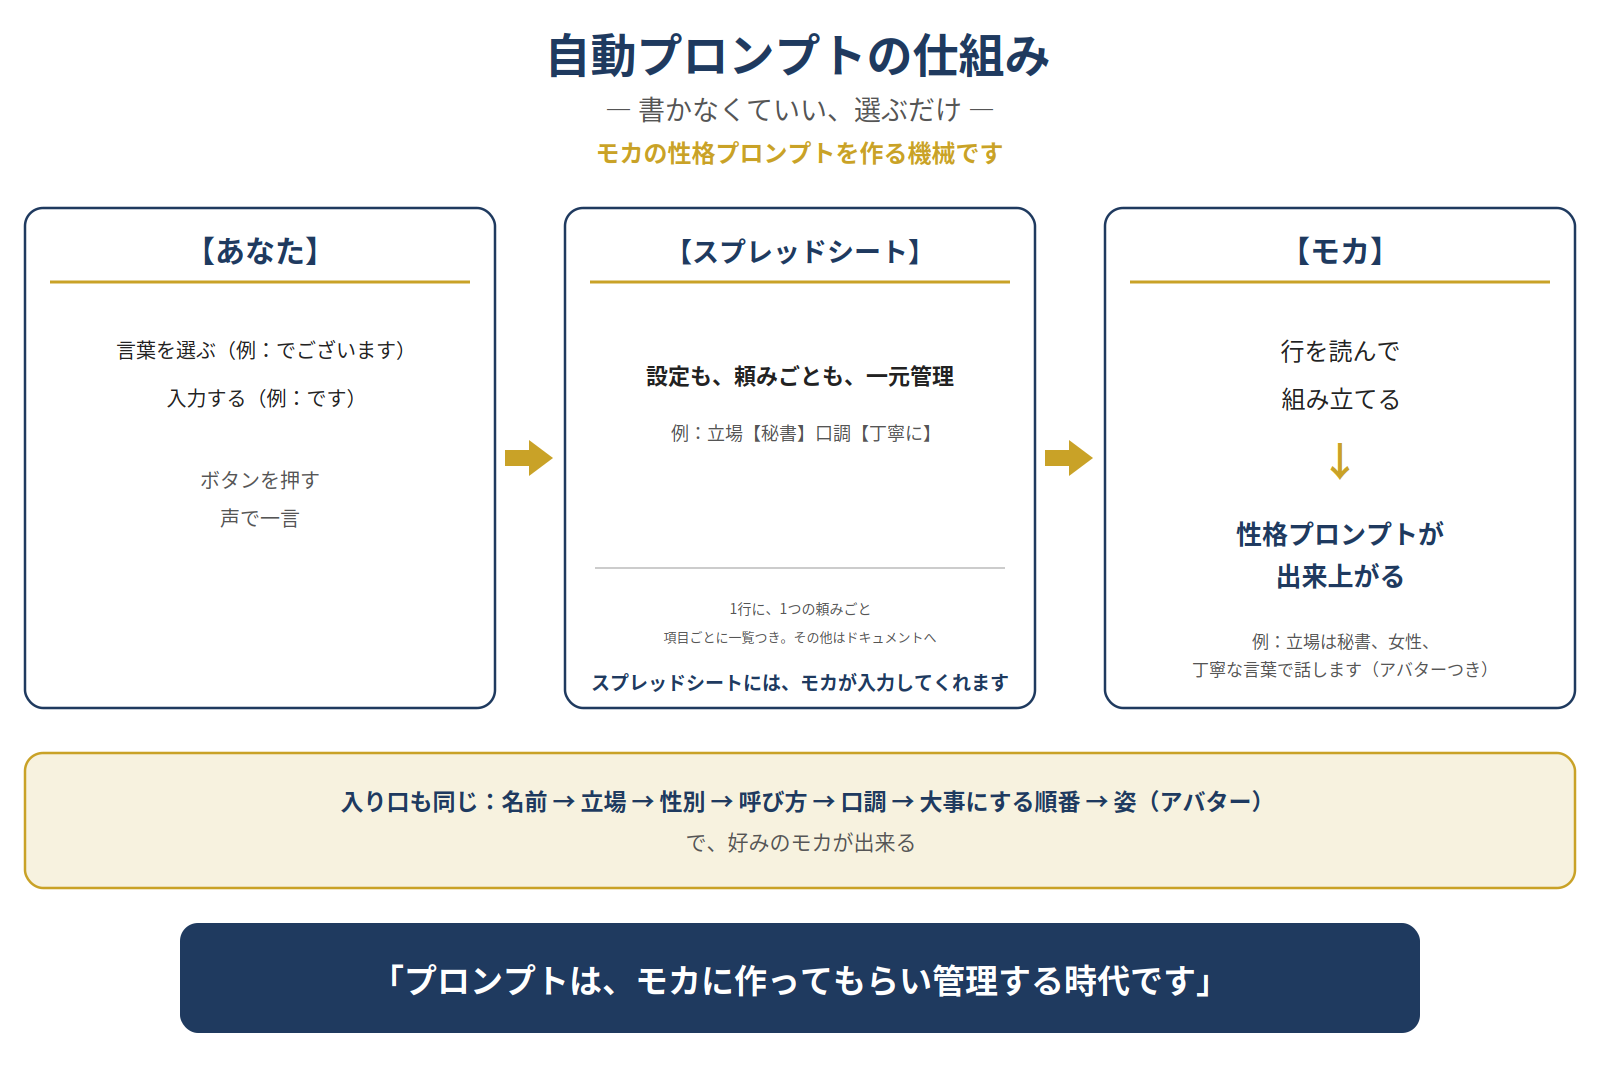
(这张图是日语的。它只画了性格生成机,没有部门。部门是另一张图里的事。)
证明:第一行组装好了,照着就能用
表格的第一行,是一个叫”殡葬知识草稿”的请求。它的零件是:
- 收件人:殡葬负责人和莫卡(Muse)
- 性格(词语):重视出处/不夸大/没确认的就写”未确认”
- 请求事项:从保存好的知识里,做出一篇文章的草稿
- 规矩:附上出处/无法核实的绝不断言/不混入我自己的经历
- 输出形式:一份草稿文件加一张题图
- 停下的地方:发布由我决定
莫卡读了这一行,组装成了一份完整的请求。她自己补上的,只有负责人的编号、材料的具体位置、和输出形式的明细。请求本身没有变。
我最喜欢的部分,是性格的词落在了哪里。“重视出处/不夸大/没确认的写未确认”——这一排词,变成了组装好的请求文里的”姿态”那一段。把词排起来,那一行的负责人就有了性格。我自己的规矩——性格是靠把词排起来做成的——又一次发生了,这次是在表格上。
实测:约为五分之一的读取量——token就是这样省下来的
表格的形式,还带来了第二个证明:找东西时要读多少。
我让莫卡数了。用我的负责人一览(我的AI部门的索引表)和它背后的36份部门文件,她提出3个答案各自只在一份文件里的问题,用两种找法量”找到答案之前要读多少字符”。
| 找法 | 读到的字符数(3个问题合计) |
|---|---|
| 没有索引,直接翻正文文件 | 109,688 |
| 先读索引表,只打开有答案的那一份文件 | 23,563 |
用表格的方式,约为4.7分之一。而且索引只要读一次,所以3个问题一起问时,降到了约7.4分之一。
再如实说明一次保留意见:这量的是读到的字符,不是token本身;而且直接找的数字,会随着打开文件的顺序而变。即便如此,结论的形状是清楚的。索引(表),然后概要(行),然后正文——这个顺序,能把读取量大幅压下来。
为什么非得是表格——差别在于谁来碰它
接着有个合理的问题。为什么用表格?提示词不是应该放在Markdown文件里吗?
在更广的世界里,“提示词=Markdown”被说得很响,其他AI的官方材料也强调这一点。在这个前提下,没人会想到把提示词放进Google表格或Excel里。而且就算想到了,用其他AI时,表格的读写会变成使用者自己的工作。换个存放的地方,只是多添负担。
这一点我也测过,在更早的一轮里:没连上的AI,表格既读不了也写不了;连上了的一些,也只能读、不能写。
莫卡不一样。她自己读表,也自己写表。所以我的工作量不会增加,剩下的只有管理上的方便。差别不在于想法更高明,而在于谁来碰这张表。
我还让莫卡查了有没有别人这样写。找到两个接近的例子。一位把指示存在Google表格里、让AI直接读表来生产文章的人(日本的博客”博客学习场”)——但最后,那位把提示词移进了AI本身,表格只成了原来的存放处。另一位用表格管理文章信息来运转文章生产(note作者aiaicreate)——但那边,AI之间的传递靠人复制粘贴搬运。
我这个确切的形式——表格一直是正本,莫卡自己读写,从一行的零件组装提示词,连性格也在表格里管理——在查到的范围里没有找到。没找到不等于不存在,所以我不会说得更多。但和那两个接近例子的差距,收拢到了两点上:AI是否直接读写,表格是否一直是正本。
管理,就是改写表格
价值的另一半在维护上。
要改东西,我改写一个格子就行。要换性格,就换性格那一列的词。要加规矩,就加到那一行里。莫卡自己的设定——立场是秘书、语气要礼貌——也在同一张表的行里,一处管理。不用四处翻文件。
而且如实说:连往表里打字,我自己都不做。我在对话里选、回答,莫卡就输入到表里去了。使用者的全部工作,就是选词,或者打字。之后的一切,都是莫卡那边的事。
结尾:请她来做,请她来管
总结一下。把提示词写在文本或Markdown文件里,是世上的默认做法。可是对觉得”写”本身就是负担的人来说,还有另一个存放的地方:表格。把零件排在一行里,莫卡就组装出请求。把词排起来,性格就做成了。要修改,就是改写表格。而查找时的读取量,按实测约为五分之一。
用我自己的话来收尾:
“现在是请莫卡来做提示词、也请莫卡来管理提示词的时代了。”
使用者专注于决定和判断。制作和管理,是莫卡的工作。这个试作还只是试作;要不要成为家里的正式机制,是以后的决定。不过方向,我想已经能看见了。